晚上多出半小时,可以运动、做饭、联系朋友,也可以早点睡。每件事单独看都合理,放进同一天,却开始争夺时间。这是“食、睡、动、连、闲”最值得深入的地方:五个词能提醒我们看见生活的不同侧面,但它们既不是五门独立的功课,也不是已经得到验证的健康评分模型。
数学的价值,在于把问题问清楚:究竟想改善什么?增加一项活动,替代了什么?看到的变化是真实改善,还是测量波动?以下把研究发现、解释性模型和待验证的想法分开。公式用来暴露假设,不用来替任何人计算寿命。
一、先选目标:关注曲线下面积
“活多久”只描述终点。另一个问题是:这段时间里,有多少日子能够自主行动、维持关系、做自己重视的事?可以用一个概念式来表达:
X(t) 代表某时刻的身体与功能状态,q 表示对这些状态的评价,积分把一段时间累积起来。这只是思考框架;本文没有给 q 赋值,更不据此给不同人的生命定价。健康目标也可能包括照顾他人、参与社会和享受当下,不能由一块表的分数代替。
2020 年《BMJ》的一项前瞻性队列研究提供了更具体的做法:用“未患研究指定疾病、已患病、死亡”三个状态,以及状态间的转移,估计不同生活方式组的无病预期寿命。这里的疾病限定为癌症、心血管病和 2 型糖尿病,“无病”并不等于没有任何健康问题。它报告的是人群中的关联,不是对个人的寿命承诺。[1]
还要避免偷换变量:那项研究的五个因素不是“食睡动连闲”。不能借它的结果,证明后者各打一个分再相乘就得到了“健康值”。相乘意味着某一项归零会让整体归零,且各项具有特定的相互作用;没有定义、校准和验证,这只是一个看似精确的比喻。
二、24 小时守恒:增加,就是替代
若把一天按互斥、穷尽的活动类别划分,便有一个硬约束:
“多运动二十分钟”因此还缺半句话:从哪里拿走这二十分钟?替代久坐与挤占睡眠,不是同一个问题。2021 年一项汇集六个前瞻性队列、共 130,239 人的研究,正是用组成数据方法分析活动、久坐与睡眠的联合分配及其与死亡率的关联。腕部和髋部设备所得结果存在明显差异,提示测量方式会影响结论;研究不能直接给出每个人的最优时间表。[2]
“连”和“闲”通常是另一层标签。和朋友散步二十分钟,可以同时具有活动、连接和休闲的意义,但时间账只能记二十分钟。吃饭也不是与运动强度互斥的时间类别,饮食质量更不能用吃饭分钟数替代。
于是,“协同”有了朴素的含义:让同一段生活承载多个有价值的目标,而不是重复计算收益。反过来,所有活动都塞满日程,即使每一项都挂着健康的名字,也可能没有给意外和恢复留下余地。
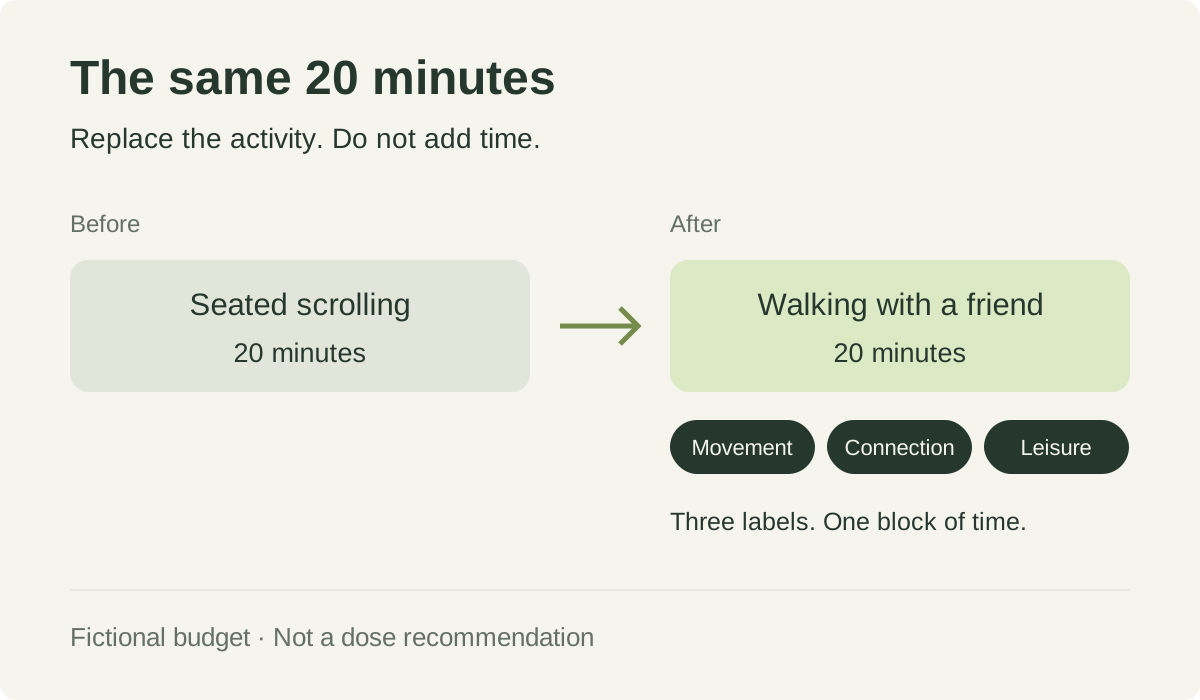
图解文字版
两个长度相同的 20 分钟窗口:从坐着刷屏改为和朋友散步。活动、连接、休闲是同一段时间的交叉标签,不是三份额外时间。睡眠和其他安排在这个虚构例子中保持不变。
三、非线性收益:下一份投入放在哪里
若收益与投入成正比,只要不断加码就行。但一项 2019 年的协调分析汇集八项研究的个体数据,发现活动量与全因死亡风险的关联呈非线性;研究对象主要是中老年人。这支持我们关注曲线形状,而不是把每增加一分钟都理解为固定收益。它仍是观察性证据,也不意味着所有健康结果都共享同一条曲线。[3]
为理解边际收益递减,可以画一条玩具曲线 B(d) = a(1 − e−bd),其中 a、b 都大于零。它越往后越平。这里没有拟合人体数据,不能用来寻找训练剂量;它只说明:已经投入很多的项目,继续加一点,未必比改善一个长期被忽略的环节更划算。
真正需要比较的是“下一份投入的预期收益、代价与不确定性”。饮食、睡眠、关系和休闲各有不同尺度,也不能统一塞进这一条饱和曲线。把某个环节叫作短板,可以帮助排序;把它理解成决定一切的唯一瓶颈,又会失真。
四、恢复是动态过程,不能只看当天分数
再引入一个局部的教学模型。设 x 是某个状态相对基线的偏离,ℓ 是新进入的负荷,k 是回归基线的速率:
假设没有新负荷、k 为正常数,便得到 x(t) = x(0)e−kt。这幅图能解释一种可能:前一次扰动尚未消退,下一次已经到来,偏离便可能累积。但它不区分训练适应、损伤、疾病或心理体验,也没有描述不同系统之间的作用。能否用于某个具体指标,必须检验局部近似、测量条件和时间尺度。
2021 年《Nature Communications》的一项研究用纵向血液指标及活动数据,研究波动与恢复速度,并在模型假设下向高龄外推。这给了“恢复能力”一个值得研究的方向;它没有证明个体应当活到哪个岁数,更没有把手表 HRV 或一次疲劳感验证成个人生物年龄。[4]
因此,“在可比条件下,某种变化是否更持久”是可以继续研究的问题;“今天恢复分低,所以已经加速衰老”则跳过了太多证据。
五、最难的一层:我们只能看到身体的一部分
上面的 X(t) 并不会直接显示在屏幕上。我们看到的是步数、主观精神、设备估算、体检结果等有限信号。控制论把这类情况称为部分可观测。用一个测量模型表示:
重复记录有时能减弱随机噪声,却不一定消除系统偏差:一把刻度偏移的尺,量一百次仍可能偏。今天比昨天高一点,也可能来自测量条件或自然波动。若每次波动都立刻触发一次调整,生活就会追着噪声走。
还有一个“可辨识性”问题:同一个观测变化,可能对应几种不同原因。若一周里同时调整饮食、运动和作息,即使精神改善,也很难把功劳分配给其中一项。增加记录条数,不会自动创造缺失的对照。好的反馈需要的不只是更多数字,还有清楚的问题、相近的比较条件,以及对“不知道为什么”的容忍。
更隐蔽的是代理目标失真。想要精力和功能,却只追逐设备分数;想要关系支持,却只计算社交次数。指标和结果相关,不代表“把指标推高”的任何方法都能改善结果。FDA 对替代终点的说明也强调:指标需要在特定情境中验证,即使经过验证,也不能单独呈现一项干预的全部收益与风险。[5]
这不是拒绝数据,而是给数据安排合适的位置:先确定关心的功能与体验,再问指标能解释多少、遗漏了什么、是否足以改变行动。测量越便宜,越要记住,容易测到的东西未必最重要。
六、把复杂模型,落成一个低负担的问题
如果把这些想法用于日常,起点不必是建立五项百分制。一种可供尝试的记录方法,是只写三件事:想改善的具体体验;准备改变的行为及其替代项;不愿牺牲的底线。这是生活安排的假设,不是医学处方。
例如在一个虚构的时间预算里,把二十分钟坐着刷屏换成与朋友散步,睡眠和其他安排保持不变。时间账是“久坐 −20,活动 +20”;连接与休闲另作标签,不再加时。随后只看它是否容易持续、主观体验如何、有没有挤占原本重视的事。无需据此估算延寿,也不必新增设备。
即使感觉变好,也只能把它当作线索:天气、工作量、期待以及自然回落,都可能参与了变化。这样的记录适合帮助安排生活,不能证明降低了长期患病风险,更不能代替诊断。出现持续或明显不适应寻求专业评估;药物调整不属于自行试错的范围。
从数学上说,这是一类多目标、带约束的选择:功能、愉悦、风险、时间和可持续性,未必能同时达到各自最大值。经济条件、照护责任和环境也会限制可行方案,不能把所有差异归结为自律。
一份好的健康安排,应当容得下生活。我们可以借助面积理解长期目标,用时间守恒检查取舍,用动态模型看待恢复,用测量模型保持谦逊。最后追求的,是更有能力、更有余地地生活,而不是赢得一场由自己设计的满分考试。